
DLRMv4 и Yambda: как честно проверить рекомендации
Наш опыт на 881 456 лайках Яндекс Музыки и пересчёт 60 журналов MLCommons. Проверяем влияние времени, повторов в данных и затрат на ускорение обучения.
Что мы выяснили
На открытых лайках Yambda свежая популярность лучше общей прошлой истории предсказывала следующий выбор. Но на результат влияют и граница времени, и повторяющиеся записи. А сокращение времени обучения DLRMv4 в опубликованных журналах сопровождалось ростом суммарных GPU-минут.
Собственный опыт на 881 456 событиях и отдельный пересчёт 60 чужих журналов. Нейросеть HSTU мы не обучали. Показатели этих двух частей нельзя сравнивать между собой.
Аннотация
Исследуем, как читать результаты рекомендательных бенчмарков и проверять рекомендации без доступа к будущим действиям пользователя. Работа состоит из двух частей. В первой независимо пересчитаны первые достижения AUC 0,75 в 60 публичных RCP-журналах DLRMv4. Во второй проведён собственный ретроспективный эксперимент на полном файле лайков Yambda-50M: три временные границы, два допустимых метода популярности и контроль с намеренной утечкой будущих данных. Недавняя популярность повысила Hit@10 относительно всей прошлой истории на 0,52-0,96 процентного пункта. Анализ точных повторов показал чувствительность одного из результатов к обработке данных. Публикуем протокол, исходники расчётов, агрегаты, проверки и ограничения. Это исследовательская заметка, а не официальный результат MLPerf или доказательство качества промышленной системы.
1. Почему эта новость важна
Представим сервис, который предлагает человеку следующую песню, статью или товар. У него две разные задачи: выбрать полезный объект и сделать это при приемлемых затратах. Быстрый сервер может обучить слабую модель. Хорошая офлайн-метрика может не превратиться в полезный пользовательский опыт. Поэтому один показатель не должен подменять остальные.
В октябре 2026 года MLCommons представила DLRMv4 для MLPerf Training. Среди авторов публикации указаны специалисты AMD, Meta, NVIDIA и ByteDance. В основе теста - последовательная модель HSTU и открытые данные Яндекс Музыки Yambda-5B. Измеряется время достижения заданного качества, а не просто число обработанных событий в секунду. [1]
Наша задача - разобрать, что можно заключить из такого теста, и провести доступную воспроизводимую проверку. Мы не сравниваем ускорители разных производителей и не объявляем новую архитектуру. Мы проверяем две инженерные границы: сколько ресурсов стоит ускорение обучения и как состав доступной истории меняет оценку простого рекомендателя.
Что меняется, если рекомендация строится только по прошлому, по недавнему прошлому или с недопустимой подсказкой из будущего?
2. Что измеряет DLRMv4
Согласно закреплённой реализации, модель получает историю и оценивает вероятность содержательного прослушивания кандидата. Критерий остановки - AUC не ниже 0,75. AUC описывает способность упорядочивать положительные и отрицательные примеры; значение 0,75 не означает «75% довольных пользователей» или «75% верных рекомендаций в первой десятке». [2]
HSTU обрабатывает последовательность взаимодействий, учитывая порядок событий. Это позволяет представить историю иначе, чем одним набором накопленных счётчиков. Однако архитектура сама по себе не устраняет ошибки данных, смещения наблюдений или неудачную постановку цели. Исходная работа HSTU и DLRMv4 решают связанные, но не тождественные задачи; показатели из разных протоколов нельзя переносить друг на друга. [3]
Yambda-5B содержит около 4,79 млрд взаимодействий, а не столько же людей. В полном наборе заявлены 1 млн пользователей и 9,39 млн треков. Пять типов событий - прослушивание, лайк, дизлайк и отмены двух оценок. Отмена лайка и дизлайк имеют разный смысл. Есть и признак is_organic, который различает органические и связанные с рекомендациями действия. [4]
Из наличия пяти типов действий не следует, что каждый из них одинаково используется конкретной моделью. Нужно читать подготовку признаков, целевую переменную и правила формирования истории. В нашем опыте ниже используется только файл лайков. Он отвечает на узкий вопрос о следующей положительной оценке и не представляет весь поток прослушиваний.
DLRMv4
Обучение HSTU до заданного AUC. В этой работе только пересчёт опубликованных журналов.
Наш опыт
Три списка популярных треков и проверка следующего лайка. Собственный запуск на открытом файле, без нейросети.
3. Пересчёт 60 журналов: быстрее не всегда дешевле
Мы взяли все 60 файлов из recommendation/rcp_logs в репозитории MLCommons на коммите e309244f7f81ecb00da434cae98355a73fc50ff0. В каждой из трёх групп по 20 начальных случайных состояний. Для каждого файла нашли первое событие eval_accuracy ≥ 0.75, число обработанных примеров и время от run_start. Хеши файлов сохранены. Это повторный анализ чужих запусков на MI350, не наши GPU-эксперименты. [5]
Все 60 журналов пересекают порог. Округлённые средние числа примеров и коэффициенты вариации совпали с таблицей источника. Время измерено до записи первого успешного оценивания и включает происходившие внутри этого интервала действия. Отсутствие run_stop в этих RCP-журналах объяснено авторами: серии продолжались для получения кривых сходимости. Мы не заменяем этот факт выдуманным статусом официального завершения.
| GPU / пакет | Примеров до порога | Минуты | GPU-минуты |
|---|---|---|---|
| 8 GPU · пакет 8 192 | 69,27 млн | 159,61 | 1 276,9 |
| 16 GPU · пакет 16 384 | 87,74 млн | 112,03 | 1 792,4 |
| 32 GPU · пакет 32 768 | 112,97 млн | 83,32 | 2 666,2 |
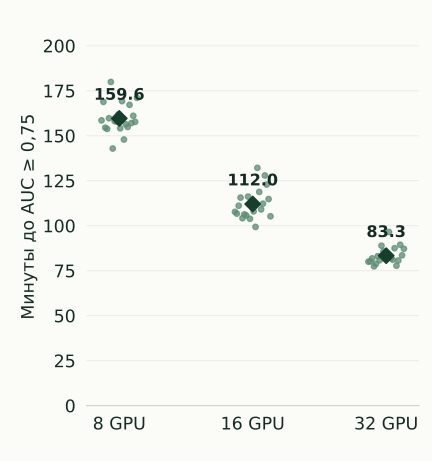
При переходе от 8 к 32 GPU среднее время сократилось в 1,92 раза. Но произведение числа ускорителей на минуты выросло в 2,09 раза: примерно с 1 277 до 2 666 GPU-минут. Это вычисляемый показатель занятого ресурса, а не измерение электричества, цены аренды или себестоимости. Число GPU взято из описания соответствующих групп.
В этих сериях одновременно менялись размер глобального пакета и целевая скорость обучения. Поэтому нельзя объяснить разницу только оборудованием или назвать её чистым тестом линейного масштабирования. Практический вывод скромнее: решение «закончить раньше» и решение «занять меньше суммарного ресурса» требуют разных критериев. В закупке или пилоте следует сохранять оба.
4. Наш эксперимент: только известное на момент рекомендации
Взяли весь flat/50m/likes.parquet из Yambda на версии dd6f3a19eef5866e346c3270e098baa641a44948. В файле 881 456 событий, 8 283 пользователя и 181 304 различных трека. Название Yambda-50M относится ко всем типам событий этого поднабора; мы не утверждаем, что обработали здесь 50 млн взаимодействий. Исходные пользовательские строки не перепубликуем.
Протокол записан до вычисления метрик. Выбраны три границы: 60%, 70% и 80% расстояния между минимальной и максимальной временной меткой файла. Это доли диапазона времени, не доли строк. Такие границы используют знание длительности собранного корпуса, поэтому исследование ретроспективное. Самим рекомендателям события после границы недоступны, кроме специально обозначенного контроля.
История всех пользователей, доступная к моменту решения
Дальше его не обновляем
Будущие действия используются только как ответы для проверки
Для каждой границы включаем только пользователей, у которых есть лайки и до, и после неё. Целевой ответ - все разные треки на самой ранней будущей временной метке пользователя. Если в один момент записано несколько лайков, не выбираем произвольно один: сохраняем весь набор. Каждый пользователь имеет одинаковый вес в пределах одной границы, независимо от числа действий.
Каталог кандидатов состоит только из треков, встречавшихся в прошлых лайках. Будущий трек, которого ещё нет в каталоге, остаётся в знаменателе оценки и не может дать попадание. Отрицательные примеры не подвыбираются. Ранее понравившиеся треки разрешено предлагать повторно: исследуется следующее событие, а не открытие обязательно нового объекта.
Сравниваем три детерминированных метода. Вся история: количество прошлых лайков каждого трека. Недавняя популярность: количество лайков в последних 20% доступного исторического диапазона. Контроль с будущим: количество лайков за весь файл, но внутри того же прошлого каталога. При равном счёте выбирается меньший идентификатор трека. Каждый метод выдаёт один глобальный список из десяти треков всем пользователям.
Это неперсонализированные ориентиры. В них нет обучения языковой модели, HSTU, подбора гиперпараметров или запросов к платным API. Между историей и проверкой нет временного зазора. Протокол отличается от официального Yambda и не воспроизводит его опубликованные таблицы.
5. Как считали качество
Hit@10 - доля пользователей, у которых хотя бы один целевой трек попал в список из десяти. Recall@10 - средняя доля найденных треков целевого набора. NDCG@10 дополнительно учитывает место: попадание ближе к началу списка получает больший вес. При нескольких одновременных лайках эти метрики могут различаться.
Для NDCG используем бинарную релевантность, вес места 1 / log₂(место + 1) и идеальный список длиной не более десяти. Сначала вычисляем показатели пользователя, затем усредняем. Для Hit@10 приводим 95%-интервалы Уилсона. Разность двух Hit@10 оценена попарно на одних и тех же пользователях, с нормальным приближением.
Интервалы описывают неопределённость в рамках наблюдаемой группы. Пользователи из трёх временных срезов пересекаются; это не три независимые выборки. Мы не складываем их размеры и не выдаём сумму за число людей. Проверки нескольких вариантов являются разведочными, поправка на множественные сравнения не применялась.
6. Результаты: свежесть помогает, но задача остаётся трудной
| Граница / группа | Вся история | Недавняя | Будущее: контроль |
|---|---|---|---|
| 60% · n = 5 516 | 2,45% (135) | 3,41% (188) | 3,79% (209) |
| 70% · n = 5 795 | 2,31% (134) | 2,83% (164) | 2,48% (144) |
| 80% · n = 6 060 | 1,45% (88) | 2,10% (127) | 1,55% (94) |
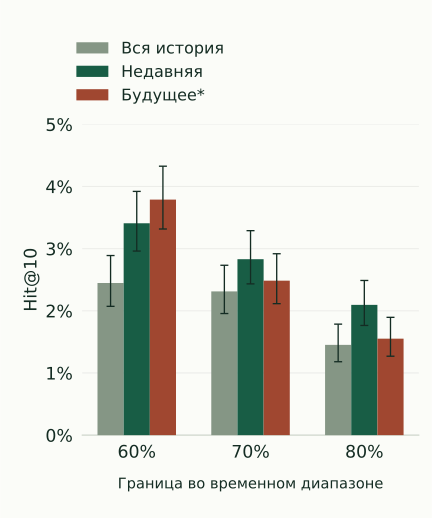
Недавняя популярность лучше всей истории на каждом из трёх срезов: +0,96, +0,52 и +0,64 процентного пункта Hit@10. Попарные 95%-интервалы разности составили соответственно [0,54; 1,39], [0,21; 0,82] и [0,33; 0,96] п.п. Это узкий результат для выбранных данных и правил, а не универсальное преимущество короткой истории.
Важна и цена улучшения для отдельных пользователей. На первом срезе недавний список исправил 98 промахов базового метода, но потерял 45 его попаданий. На следующих срезах это 56 против 26 и 66 против 27. Положительное среднее не означает, что каждый человек получил более подходящую рекомендацию.
Контроль с будущим на первом срезе увеличил число попаданий со 135 до 209. Но эффект нарушения неодинаков: на двух следующих срезах его прибавка мала, а интервалы попарной разности включают ноль. Утечка делает тест некорректным независимо от того, выросла ли метрика заметно. По одной красивой или некрасивой цифре нельзя определить честность протокола.
У всех методов низкое абсолютное качество. В исходном варианте максимальный допустимый Hit@10 здесь 3,41%. Один общий список по популярности редко угадывает следующий лайк конкретного человека. Кроме того, 20,38-21,62% целевых пар «пользователь - трек» относятся к объектам без прошлых лайков в выбранном каталоге. Это ограничение наших кандидатов, не доказательство того, что трек был новым в Яндекс Музыке.
Recall@10, NDCG@10 и размеры каталогов
| Граница / метод | Recall@10 | NDCG@10 |
|---|---|---|
| 60% / Вся история | 2,070% | 0,00912 |
| 60% / Недавняя | 3,092% | 0,01721 |
| 60% / Будущее (контроль) | 3,422% | 0,01985 |
| 70% / Вся история | 1,918% | 0,00814 |
| 70% / Недавняя | 2,471% | 0,01433 |
| 70% / Будущее (контроль) | 2,118% | 0,01320 |
| 80% / Вся история | 1,167% | 0,00505 |
| 80% / Недавняя | 1,836% | 0,01023 |
| 80% / Будущее (контроль) | 1,258% | 0,00761 |
| Граница | Прошлых событий | Кандидатов | Целевых пар | Без истории в каталоге |
|---|---|---|---|---|
| 60% | 447 105 | 121 347 | 7 069 | 1 528 |
| 70% | 532 276 | 134 035 | 7 364 | 1 515 |
| 80% | 631 354 | 148 481 | 8 508 | 1 734 |
Отдельно посчитаны группы органических, алгоритмических и смешанных целевых событий. Например, для недавнего списка на первом срезе Hit@10 составляет 3,84% у 3 488 пользователей с органическими целями и 2,56% у 1 990 с алгоритмическими. Это наблюдательные группы с разным составом. Разница не доказывает причинный эффект рекомендательной системы; смешанная группа мала и вынесена в данные без обобщающего вывода.
7. Повторы: небольшая доля строк, заметная смена результата
В исходном файле нет пустых обязательных полей или значений is_organic вне 0/1. Однако обнаружены 6 405 точных повторов по всем четырём полям. После удаления лишних копий остаётся 875 051 строка. Без идентификатора исходного события нельзя уверенно сказать, являются ли совпадения техническими дублями или отражают особенности регистрации и округления времени.
Поэтому основной опыт сохраняет записи как опубликовано. После обнаружения повторов мы отдельно провели последующий анализ чувствительности: повторили расчёт на уникальных строках. Это дополнение после основного опыта, а не заранее зарегистрированная проверка.
На границе 70% у метода всей истории заменился один из десяти треков. Число попаданий снизилось со 134 до 99, то есть Hit@10 изменился с 2,31% до 1,71%. Число попаданий двух других методов на этом срезе не изменилось. На границах 60% и 80% числа попаданий всех трёх методов сохранились.
Преимущество недавней популярности по Hit@10 остаётся на всех границах, но размер эффекта зависит от обработки записей. Это полезнее формального «данные очищены»: нужно публиковать правило обработки и его влияние. В задаче подсчёта популярности каждая повторная строка меняет вес, а небольшое смещение около десятого места способно заменить рекомендацию для всей аудитории.
8. Что это меняет в работе с ИИ-агентами
У рекомендателя и агента разные задачи, но есть общая проблема оценки: системе нельзя давать сведения, которых у неё не было в момент решения. При проверке поиска по памяти документ должен существовать к нужному моменту. При выборе инструмента нельзя подмешивать результат будущего вызова. При оценке персонального помощника позднее исправление пользователя не должно незаметно становиться исходной подсказкой.
Наш опыт не проверяет CapyAgent и не устанавливает, что его память уже обладает такими гарантиями. Он даёт конкретное требование к будущим проверкам: сохранять снимок доступной информации, время решения, набор допустимых кандидатов и отдельно - последующие ответы. Для поиска и выбора инструментов эти элементы нужно определять заново, по реальному продукту.
Второй вывод касается затрат. Время получения ответа, время обучения, число обработанных примеров и занятый вычислительный ресурс следует записывать раздельно. Быстрее завершившийся запуск может занимать больше ускорителей. Более высокий Hit@10 может сопровождаться потерей попаданий у другой части аудитории. Практическое решение должно видеть этот обмен, а не только лучшую строку таблицы.
Следующие исследовательские шаги: добавить персонализированный метод на тех же временных границах; проверить отдельную задачу по прослушиваниям и отменам оценок; испытать временную доступность документов в памяти агента. Это планы, не выполненные эксперименты. Перенос результатов музыкального набора на бизнес-процессы потребует собственных данных и отдельной проверки.
9. Материалы и воспроизводимость
Расчёты выполнены 6 ноября 2026 года на CPU KotikTurbo в изолированном окружении: Python 3.14.8, DuckDB 1.4.4, один вычислительный поток. Процесс ограничен 1,5 ГиБ памяти; настройка DuckDB - 700 МБ. Графики построены Matplotlib 3.10.8 из сохранённых результатов. Нагрузка на рабочий сайт не создавалась. Скорость нашего CPU-запуска не сравнивается со временем обучения на GPU.
Основные метрики заново вычислены отдельной реализацией на Python-счётчиках, без импорта функций оценщика: совпали все 36 сочетаний метода, временной границы и группы. Отдельно проверены первые пересечения порога в 60 журналах. Такой пересчёт помогает найти ошибку реализации, но не является внешним рецензированием.
В архиве есть протокол, исходники, агрегированные результаты, контрольные суммы и инструкция. Открытые исходные данные и журналы загружаются из закреплённых версий upstream. Мы не распространяем пользовательские истории. Для данных сохраняются атрибуция Яндекса и ссылка на условия набора; карточка указывает Apache 2.0 и научно-исследовательское назначение. Лицензия нашего кода не заменяет условия сторонних материалов.
10. Ограничения и вывод
Это узкий эксперимент на лайках, а не обучение DLRMv4, тест всей Yambda или сравнение современных рекомендательных моделей. Лайки редки относительно прослушиваний; часть пользователей набора не оставляла лайков. Мы не моделировали отмены оценок, длительность прослушивания, персональные предпочтения, новые объекты вне прошлого каталога или долговременную удовлетворённость.
Фиксированный список остаётся неизменным до первого будущего действия каждого пользователя, а ожидание этого действия может быть разным. Следовательно, в оценке смешаны разные горизонты прогноза. Границы и ширина недавнего окна выбраны исследователем, а не доказаны оптимальными. Для промышленного вывода нужны дополнительные временные интервалы, сильные методы сравнения и проверка на целевом продукте.
Пересчёт RCP доверяет опубликованным событиям журнала и описанию оборудования: мы не присутствовали при обучении и не измеряли энергопотребление. Он подтверждает арифметику выбранных показателей, но не независимое воспроизведение запусков. Порог AUC 0,75 также нельзя сопоставлять с нашим Hit@10: это разные задачи и метрики.
Наш вывод: полезность бенчмарка начинается с проверяемого протокола. На выбранных данных свежая популярность оказалась лучше накопленной, однако временная граница и точные повторы заметно меняют оценку. В опубликованных сериях DLRMv4 больше ускорителей сокращали ожидание, увеличивая GPU-минуты. Эти результаты помогают ставить следующие опыты; они не дают готового обещания роста продаж или качества любого ИИ-продукта.
Исследовательская заметка центра, редакция 1 от 6 ноября 2026 года. Расчёты программные; текст подготовлен с помощью ИИ. Внешнее научное рецензирование не проводилось.
Источники и данные
- MLCommons. DLRMv4 Training, октябрь 2026. Объявление бенчмарка и авторы. Используется для контекста, не как наш результат.
- MLCommons Training. Recommendation v4: спецификация и воспроизведение. Закреплённый коммит e309244f, разделы метрики, временного разделения и RCP.
- Zhai J. и др. Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations. 2024. Первичная работа по HSTU; её промышленные показатели здесь не воспроизводятся.
- Ploshkin A. и др. Yambda-5B: A Large-Scale Multi-modal Dataset for Ranking and Retrieval. Версия 2, 2025. Происхождение данных и исходный протокол оценки.
- MLCommons: все 60 исходных RCP-журналов. Основание нашего вторичного анализа, сохранены имена и SHA-256.
- Яндекс. Набор Yambda, закреплённая версия dd6f3a19. Файл flat/50m/likes.parquet; лицензия набора.
- Смольников Исследования. Протокол, расчёты, проверки и результаты настоящей работы. 06.11.2026. Собственный первичный опыт и вторичный пересчёт различены в файлах.
Первоисточники проверены 6 ноября 2026 года. Указание организаций и программных продуктов не означает партнёрства с центром.
Следующий шаг
Нужна такая проверка для вашей системы?
Обсудим вопрос, данные и результат, который поможет принять решение.